Können diese KI-Sprachprogramme auch Emotionen beim Singen simulieren?
Kann KI Emotionen beim Singen simulieren? Woraus Gefühl im Gesang besteht, welche Regler Synthesizer V, ACE Studio und Co. bieten und wo es noch hakt.
Ja, mit KI Emotionen beim Singen zu simulieren, gelingt heute überzeugend, wenn ein Mensch die Richtung vorgibt: Gesangssynthesizer wie Synthesizer V oder ACE Studio steuern Dynamik, Atem, Vibrato und Klangfarbe per Regler, Voice Conversion übernimmt das Gefühl aus deiner eigenen Aufnahme. Ohne Vorgaben wählt die KI meist eine mittlere, eher glatte Interpretation.
Mit „KI-Sprachprogrammen“ sind hier drei Werkzeugfamilien gemeint. Gesangssynthesizer wie Synthesizer V, ACE Studio und VOCALOID singen Noten und Text, die du eingibst. Voice Conversion wie bei Kits.ai, dem ElevenLabs Voice Changer oder Soundverse Voice Swap verwandelt eine Aufnahme in eine andere Stimme. Und Generatoren steuerst du per Text, vom Song-Generator bis zur Sprach-KI mit Emotions-Tags.
Alle Angaben stammen aus den Dokumentationen der Hersteller, abgerufen am 21. November 2026. Dreamtonics sperrt automatisierte Abrufe; Synthesizer V haben wir deshalb über Archivkopien vom 1. April, 13. und 15. November 2026 gelesen.
Woraus Emotion im Gesang besteht
Was wir als traurig, wütend oder zärtlich hören, lässt sich messen. Für eine 2015 in Computer Speech and Language erschienene Studie um Klaus R. Scherer und Johan Sundberg sangen drei international bekannte Opernsänger:innen kurze Phrasen in zehn verschiedenen Emotionen. Das Ergebnis im Abstract: „In addition to the obvious effects of loudness and tempo, spectral balance and perturbation make significant contributions (high effect sizes) to this differentiation.“
Auf Deutsch: Neben Lautstärke und Tempo unterscheiden vor allem die Klangfarbe, also die Verteilung der Energie im Spektrum, und kleine Unregelmäßigkeiten der Stimme die Gefühle voneinander. Sänger:innen setzen laut der Studie stärker als Schauspieler:innen auf Vibrato, besonders bei Emotionen mit hoher Erregung.
Für die Arbeit mit KI lassen sich daraus sieben Bausteine ableiten:
- Dynamik: wie laut, mit wie viel Druck, und wie sich das innerhalb einer Phrase verändert.
- Timing: ob eine Silbe vor oder hinter dem Beat kommt und wie lange ein Ton gehalten wird.
- Vibrato: ob, wann und wie tief. Ein Vibrato, das erst spät im Ton einsetzt, wirkt anders als eines ab dem ersten Moment.
- Atem: hörbares Einatmen vor einer Phrase, Luft im Ton, ein Seufzer am Ende.
- Klangfarbe: gepresst oder locker, Brust- oder Kopfstimme, hell oder dunkel.
- Verzierungen: Schleifer in den Ton, kleine Melismen, Fall-offs am Phrasenende.
- Konsonanten-Attacke: Ein hart angesetztes „k“ in „kalt“ klingt anders als ein weiches „w“ in „warum“.
Welche Regler dir KI-Gesangsprogramme heute geben
Nach Baustein sortiert, so wie die Hersteller es dokumentieren:
Dynamik. In ACE Studio formt eine einzige Dynamic-Kurve die Intensität von sanft bis kraftvoll. Zeichnest du nichts, leitet die KI die Dynamik laut ACE-Dokumentation aus Melodie, Text und Gesangsstil der Stimme ab. Synthesizer V hat dafür Loudness und Tension: Weniger Tension macht die Stimme weicher, mehr klingt angespannter. Bei Kits.ai bestimmt der Wert modelVolumeMix, ob die Lautstärke des Stimmmodells oder deine eigene Dynamik durchkommt; die API-Doku rät, ihn zu senken, um die Dynamik der Eingangsaufnahme zu hören.
Klangfarbe und Stimmung. Synthesizer V Studio 2 Pro bietet je nach Stimme eigene Vocal Modes, bei der Stimme Mai 2 etwa Breathy, Downer, Emotional, Powerful, Rap und Sweet. Sie lassen sich mischen und verändern laut Handbuch neben dem Timbre auch Aussprache und Tonhöhenverlauf. VOCALOID7 wechselt per VOICE TYPE zwischen Klangcharakteren derselben Stimme, ACE Studio bietet unter Advanced die Werte Air, Falsetto, Tension und Energy. Einen ausführlichen Vergleich zeigt unser Artikel darüber, welche Software die beste Kontrolle über den vokalen Ausdruck bietet (auf Englisch).
Vibrato und Tonhöhenverlauf. Synthesizer V hat eine Vibrato-Hüllkurve (Vibrato Envelope), die die Intensität im Verlauf eines Tons verändert, und ein Expression Pad: „Vibrant“ erzeugt einen ausdrucksstärkeren Stil mit tieferem Vibrato, „Raw“ reduziert die interne Tonhöhenkorrektur und klingt menschlicher, liegt dafür aber öfter neben dem Ton. ACE Studio setzt Vibrato automatisch anhand der MIDI-Daten und der Stimme; du kannst es glätten und mit dem Vibrato-Werkzeug neu zeichnen.
Atem. ACE Studio setzt mit „Add all“ Atemzüge an passende Stellen wie Phrasenanfänge, einzelne setzt du per Klick. In Synthesizer V regelt Breathiness, wie viel Hauch im Ton steckt.
Konsonanten und Timing. In ACE Studio verschiebst du die Grenzen zwischen Phonemen. Ein längerer Konsonant gibt der Silbe laut Doku einen stärkeren, bewussteren Anschlag, ein kürzerer macht den Übergang weicher. VOCALOID7 bringt dafür den neuen Parameter ATTACK mit, der steuert, wie deutlich die Aussprache klingt.
Verzierungen. In den Handbüchern, die wir gelesen haben, gibt es dafür kaum eigene Regler. Schleifer und Fall-offs zeichnest du als Tonhöhenkurve oder singst sie vor. Eine Ausnahme ist ACE Studios Stil „Chinese Opera“, der bei passenden Stimmen die typischen melismatischen Verzierungen dieser Tradition hinzufügt.
Text-Tags und Prompts. Bei seiner Sprach-KI steuert ElevenLabs Emotionen mit Audio-Tags wie [whispers], [sighs], [excited] oder [crying]; [sings] führt die Doku als experimentellen Tag. Für Musik empfiehlt ElevenLabs Beschreibungen wie „breathy“, „whispered“ oder „belted“. Im AI Song Generator von Soundverse gibst du die Richtung im Custom-Modus über Style of Music und bis zu fünf Quick-Style-Tags vor.
Kann eine KI Emotionen in synthetisch erzeugten Gesang einbauen?
Ja, auf drei Wegen, je nachdem, wer die Emotion liefert.
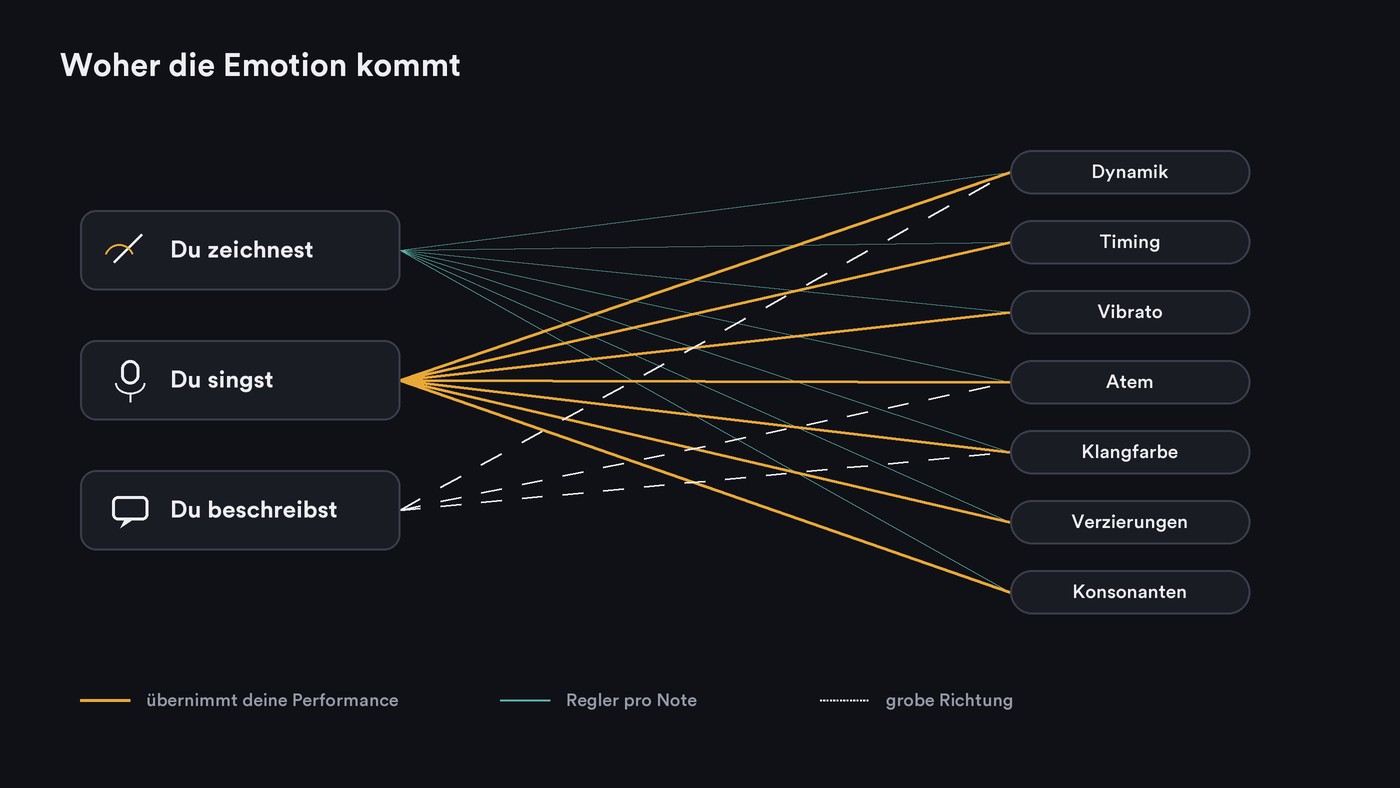
- Die KI rät. Ohne Eingriff leitet sie Dynamik, Vibrato und Timing aus Melodie, Text und Stimme ab. Dreamtonics erklärt auf seiner Produktseite, dass frühe neuronale Gesangsmodelle eine gemittelte Version der gesungenen Lyrics vorhersagten, und dass es für dieselbe Partitur mehr als eine richtige Interpretation gibt. Deshalb klingt der Autopilot oft sauber, aber neutral.
- Du gibst sie vor. Mit Kurven, Modi, Tags oder Prompt-Beschreibungen. Das funktioniert, kostet aber Zeit, und Text-Tags befolgen die Modelle noch nicht immer zuverlässig. ElevenLabs schreibt in seiner Doku offen über die Audio-Tags: „They're not perfect yet, and we're continuing to iterate and improve how reliably the model follows tag instructions“.
- Du lieferst sie mit. Voice Conversion tauscht die Stimme und behält die Performance. ElevenLabs beschreibt seinen Voice Changer so, dass er Flüstern, Lachen, Weinen und feine emotionale Nuancen der Ausgangsaufnahme erfasst. Soundverse Voice Swap ändert die Stimme, nicht die Performance; Phrasierung und Timing deines Takes bleiben erhalten.
Für ein bestimmtes Gefühl in einer bestimmten Zeile ist der dritte Weg bis heute der verlässlichste.
Wo KI-Gesang emotional noch an Grenzen stößt
- Deutsch ist nicht überall dabei. Synthesizer V Studio 2 Pro nennt auf seiner Produktseite Englisch, Japanisch, Mandarin, Kantonesisch, Spanisch und Koreanisch. VOCALOID:AI-Stimmen singen laut Yamaha Japanisch, Englisch und Chinesisch. Bei ACE Studio hängt die Sprachunterstützung laut Doku von der Modellversion ab. Der Voice Changer von ElevenLabs unterstützt mit dem Modell Multilingual v2 auch Deutsch. Für Soundverse v9 gibt es keine veröffentlichte Sprachliste, Soundverse rät deshalb, zuerst eine kurze Strophe zu testen.
- Der Bogen über den ganzen Song. Die Steigerung von der leisen ersten Strophe bis zum letzten Refrain musst du meist selbst planen.
- Extreme. Eine Stimme, die beim Singen bricht, ein Lachen mitten in der Zeile, Weinen auf einem gehaltenen Ton: In den Gesangs-Handbüchern, die wir gelesen haben, gibt es dafür keine eigenen Regler. Tags wie [crying] sind bei ElevenLabs für Sprache gedacht.
- Tags werden missverstanden. Laut ElevenLabs liest das Modell einen Tag gelegentlich als Soundeffekt statt als Vortragsanweisung; beschreibende Tags wie [low, gravelly voice] helfen.
- Conversion kann nur, was im Take steckt. Singst du flach, bleibt es flach. Und je stärker die Umwandlung, desto mehr Akzent der Zielstimme: Bei Kits.ai erhöht conversionStrength laut Doku den Akzent des Stimmmodells und kann zu Aussprachefehlern führen.
So holst du mehr Emotion aus KI-Gesang
- Sing eine Guide-Vocal, auch ohne Profistimme. Phrasierung, Pausen und Betonung sind das Wertvollste an deiner Aufnahme. Tipps für die eigene Stimme gibt unser Artikel zum Verbessern deiner Singstimme (auf Englisch).
- Schreib eine Emotionskarte. Notier pro Abschnitt zwei, drei Wörter: „Strophe 1: nah, müde, fast gesprochen. Refrain: offen, laut, Bruststimme. Letzter Refrain: gepresst, Stimme kippt.“ Diese Wörter übersetzt du in Kurven, Vocal Modes oder Prompts.
- Arbeite Phrase für Phrase. In Synthesizer V erzeugt AI Retake neue Varianten nur für Tonhöhe, Timing oder Timbre einer Auswahl. In Eleven Music lässt sich ein einzelner Abschnitt eines Songs neu generieren. Mach drei Takes pro Phrase und stell die besten zusammen.
- Setz Konsonanten bewusst. Verlängere den ersten Konsonanten des Schlüsselworts: Ein längeres „k“ in „kalt“ klingt entschlossener, ein kurzes „w“ in „warum“ weicher.
- Leg eine menschliche Dopplung darunter. Deine eigene, leise gemischte Dopplung unter dem KI-Lead bringt kleine Timing- und Tonhöhenabweichungen, die das Ganze lebendiger machen. Wie du Dopplungen und Harmonien schichtest, zeigt unser Guide zum Layern von Vocals (auf Englisch).
- Misch für Dynamik. Fahr die Lautstärke mit Automation, statt alles mit Kompression plattzumachen, und lass die Atemzüge drin.
Wo Soundverse ins Spiel kommt
Soundverse ist eine KI-Musikplattform, die dich von der Idee bis zum Publikum begleitet, gebaut für unabhängige Künstler:innen, die Musik veröffentlichen. Für emotionale Vocals setzt Soundverse auf deine Performance. Voice Swap singt deinen Take in einer anderen Stimme nach, ab dem Creator-Tarif auch in einem selbst trainierten Stimmmodell; Phrasierung und Timing bleiben deine. Voice Swap selbst läuft auf jedem Tarif, auch im Free-Tarif. Mit Train Voice Clone trainierst du ab dem Creator-Tarif einen Klon aus einer Aufnahme mit mindestens 15 Sekunden Gesang. Soundverse schlägt vor, einen Klon aus einem gehauchten und einen aus einem kraftvoll gesungenen Take zu trainieren und je nach Song zu wählen. VocalDuality One macht in AI Studio aus einem Take bis zu vier Kopien mit eigenem Timing, Pitch-Drift und Panorama, auf jedem Tarif. Für Kurven Phonem für Phonem nimmst du einen Gesangssynthesizer.
Im Edit-Walkthrough zeigt Soundverse ab 2:18 Voice Swap: dieselbe Performance in einer neuen Stimme.
FAQ
Kann eine KI beim Singen weinen oder lachen? Nicht verlässlich. ElevenLabs bietet Tags wie [crying] und [laughs] für gesprochene Sprache. Für Gesang ist der sichere Weg, den Moment selbst zu singen und danach die Stimme per Voice Conversion zu tauschen.
Welches Programm eignet sich für emotionalen deutschen Gesang? Prüf zuerst die Sprache: Synthesizer V Studio 2 Pro und VOCALOID7 führen Deutsch nicht unter ihren Gesangssprachen. Verlässlich wird deutscher Gesang, wenn du ihn selbst einsingst und die Stimme per Voice Conversion änderst, etwa mit Soundverse Voice Swap.
Klingt ein Stimmklon so emotional wie das Original? Ein Klon lernt aus der Aufnahme, mit der du ihn trainierst. Soundverse rät, trocken und mit einer Bandbreite an Tönen und Emotionen aufzunehmen, und schlägt getrennte Klone für unterschiedliche Ausdrucksweisen vor. Die Emotion einer bestimmten Zeile kommt trotzdem aus Text, Prompt oder Performance.
Wem gehören die Rechte, wenn eine KI meinen Song singt? Die SUISA schreibt für die Schweiz: Stammen Text und Komposition von dir und wurde nur die Stimme mit KI erzeugt, stehen dir 100 % der Rechte zu; die AGB des KI-Dienstes können Einschränkungen enthalten. Mehr dazu auf ihrer Seite zu KI-generierten Musikstücken. In Deutschland und Österreich fragst du im Zweifel bei GEMA oder AKM nach.
Melde dich kostenlos bei Soundverse an und hör deinen eigenen Take mit Voice Swap in einer neuen Stimme. Mehr Vocal-Guides findest du im Soundverse-Blog.

