एआई म्यूजिक जनरेटर कैसे काम करते हैं?
AI म्यूजिक जनरेटर कैसे काम करते हैं, आसान Hindi में: training, tokens, text encoder, diffusion, decoder, गायकी की मुश्किल और prompt के सही शब्द।
AI म्यूजिक जनरेटर पहले बहुत सारे संगीत को उसके लिखित विवरणों के साथ सुनकर सीखते हैं कि कौन-से शब्द किस आवाज़ से जुड़े हैं। फिर आपका prompt अंकों में बदलता है, model उसके सहारे संगीत का सिकुड़ा हुआ रूप बनाता है, अगला token अनुमान लगाकर या noise हटाकर, और decoder उसे सुनने लायक audio में बदल देता है।
यह गाइड उन कलाकारों के लिए है जो बिना गणित के समझना चाहते हैं कि prompt डालने के बाद अंदर क्या होता है। उदाहरण Google, Meta, Stability AI और दूसरी research टीमों के प्रकाशित papers और model cards से हैं, जिन्हें हमने 19 नवंबर 2026 को पढ़ा। Commercial tools अपना तरीका आम तौर पर नहीं बताते, इसलिए यहाँ किसी खास app की नहीं, आम सिद्धांत की बात है। तकनीकी गहराई के लिए हमारी English गाइड neural networks text prompt से संगीत कैसे बनाते हैं पढ़िए।
AI म्यूजिक जनरेटर की पूरी प्रक्रिया, पाँच कदमों में
- सीखना: model संगीत और उसके विवरण साथ-साथ देखकर शब्दों और आवाज़ों का रिश्ता सीखता है।
- सिकोड़ना: audio को छोटे codes (tokens) या एक compressed "latent" रूप में बदला जाता है।
- Prompt पढ़ना: text encoder आपके शब्दों को अंकों की सूची में बदलता है।
- बनाना: generator अगला token अनुमान लगाता है, या noise को कदम-दर-कदम साफ़ करता है।
- सुनाना: decoder उस सिकुड़े रूप को वापस सुनने लायक आवाज़ में बदलता है।
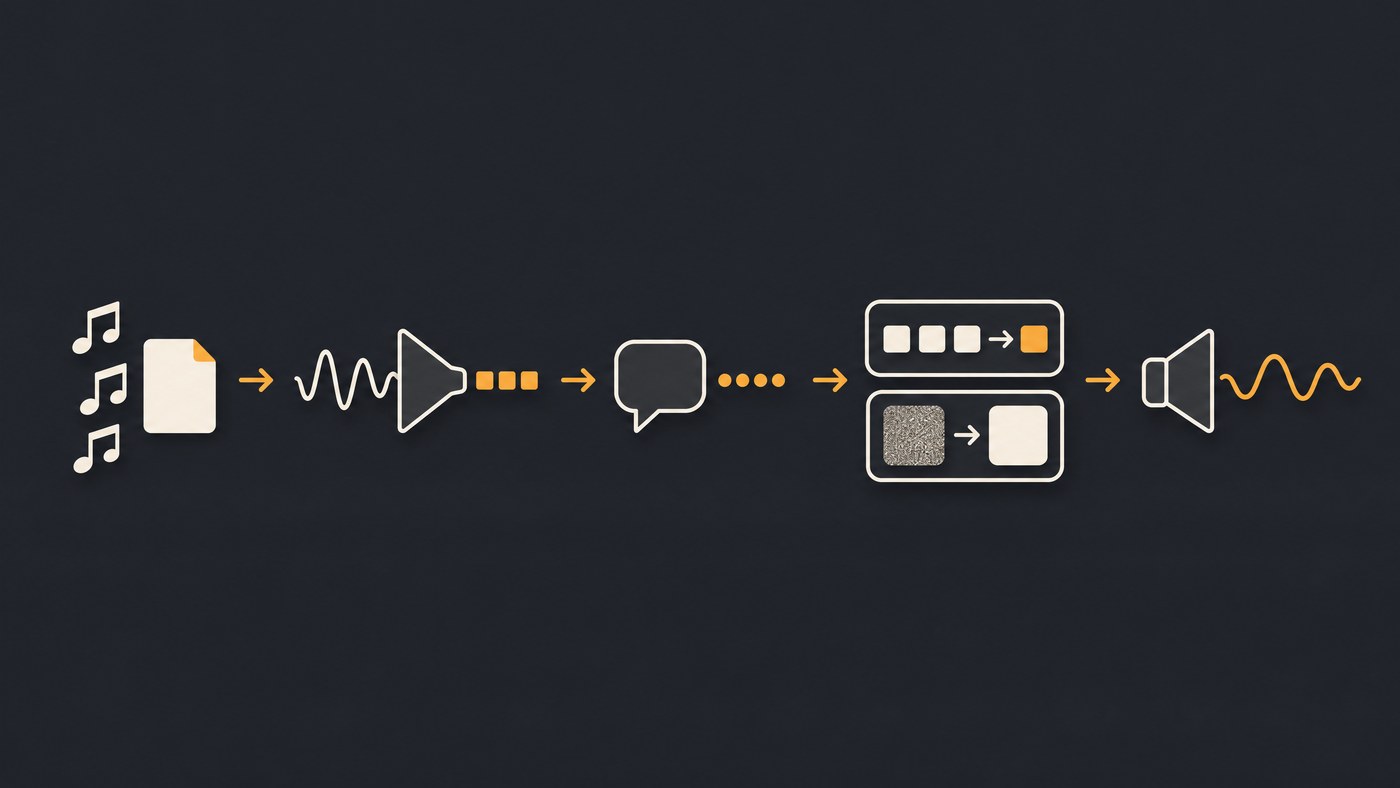
कदम 1: training, यानी संगीत को उसके विवरण के साथ सुनना
सोचिए कोई शागिर्द हज़ारों recordings सुन रहा है, और हर recording के साथ उस्ताद एक पर्ची थमा देते हैं: "धीमी लय, उदास मूड, सितार और तानपुरा"। काफ़ी सुनने के बाद वह शब्द पढ़ते ही आवाज़ का अंदाज़ा लगाने लगता है। AI model भी ऐसे ही सीखता है, बस पैमाना मशीनी होता है।
- Meta के MusicGen (जून 2023) के paper के मुताबिक़ हर training track के साथ metadata था: text description, genre, BPM और tags। Model card के अनुसार कुल data 20,000 घंटे का था।
- Google के MusicLM (जनवरी 2023) की टीम ने MusicCaps नाम का dataset जारी किया: करीब 5,500 संगीत clips, हर एक के साथ विशेषज्ञों का लिखा विवरण।
- Stability AI के Stable Audio Open (जुलाई 2024) को Freesound और Free Music Archive की 4,86,492 Creative Commons recordings पर train किया गया, करीब 7,300 घंटे।
सबक सीधा है: model उन्हीं शब्दों को आवाज़ से जोड़ पाता है जो training में आवाज़ के साथ आए थे। MusicGen के model card में Meta ने खुद लिखा है: "The source of data is potentially lacking diversity and all music cultures are not equally represented in the dataset." भारतीय कलाकार के लिए इसका मतलब यह हो सकता है कि ठुमरी, लोकगीत या किसी क्षेत्रीय शैली पर ऐसा model उतना भरोसेमंद न निकले।
कदम 2: आवाज़ को tokens या latent में सिकोड़ना
Audio बहुत भारी होता है, एक सेकंड में हज़ारों अंक। इसलिए model उसके सिकुड़े रूप पर काम करता है। इसे सरगम से समझिए: "सा रे ग म" वाली एक line पूरी धुन को चंद अक्षरों में समेट लेती है, और गवैया उसे पढ़कर फिर गा देता है। Neural codec ऐसी ही एक लिपि खुद सीखता है, जो इंसान के पढ़ने लायक नहीं होती।
- Tokens: MusicGen, EnCodec नाम के codec से 32 kHz audio को 50 frames प्रति सेकंड में बदलता है, और हर frame चार codes से लिखा जाता है। 30 सेकंड का संगीत इस तरह 1,500 कदमों का क्रम बन जाता है।
- Latent: Stable Audio Open का autoencoder waveform को अलग codes में नहीं, अंकों के एक लगातार रूप में दबाता है। इसे गाने का नक्शा समझिए: पूरी इमारत नहीं, उसका ब्लूप्रिंट।
कदम 3: text encoder आपका prompt कैसे पढ़ता है
पहले एक pretrained text encoder आपके prompt को अंकों की लंबी सूचियों (vectors) में बदलता है, जिनमें शब्दों का मतलब और आपसी रिश्ता दर्ज होता है। MusicGen इसके लिए T5 नाम का encoder इस्तेमाल करता है, और Stable Audio Open भी T5 पर आधारित encoder। जैसे music director arranger को brief देता है और arranger उसे अपने काम की भाषा में बदल लेता है।
भारतीय कलाकारों के लिए ज़रूरी बात: ये research models मुख्य रूप से English विवरणों पर train हुए हैं। MusicGen का model card कहता है कि वह दूसरी भाषाओं में उतना अच्छा काम नहीं करेगा, और Stable Audio Open का paper भी यही कहता है। इसलिए किसी भी tool में style वाला हिस्सा Hindi और English, दोनों में आज़माकर सुनिए।
कदम 4 और 5: संगीत बनना, फिर आवाज़ में लौटना
अगला token अनुमान लगाना
Autoregressive models संगीत को वाक्य की तरह बनाते हैं: एक token, फिर उसके आधार पर अगला। तबला वादक को सोचिए जो ठेका आगे बढ़ाता है: हर अगला बोल पिछले बोलों पर टिका होता है। MusicLM यह काम परतों (hierarchical) में करता है; उसके paper के मुताबिक़ वह 24 kHz पर ऐसा संगीत बनाता है जो कई मिनट तक सुसंगत (consistent) रहता है। MusicGen यही काम एक ही transformer से करता है। कमज़ोरी यह कि शुरुआत का गलत मोड़ आगे तक साथ चलता है।
Diffusion: खरखराहट से साफ़ आवाज़ तक
पुराने रेडियो की सुई घुमाइए: पहले सिर्फ़ खरखराहट, फिर धीरे-धीरे स्टेशन साफ़ होता है। Diffusion model भी random noise से शुरू करता है और हर कदम पर उसका थोड़ा हिस्सा हटाता है, prompt की दिशा में। Jonathan Ho, Ajay Jain और Pieter Abbeel के जून 2020 के paper ने images पर दिखाया था कि इस तरीके से ऊँची quality की तस्वीरें बन सकती हैं। Stable Audio Open यही तरीका audio के latent पर लगाता है: 100 कदम, और एक run में 47 सेकंड तक का stereo audio। पूरा clip एक साथ आकार लेता है, पर window की लंबाई ही run की लंबाई तय करती है।
आख़िर में decoder tokens या latent को वापस waveform में बदलता है; Stable Audio Open का decoder 44.1 kHz का stereo audio देता है। जो भी बना, इसी decoder से होकर आता है, इसलिए उसकी quality पूरी आवाज़ की छत है।
बोल और गायकी: दूसरी, अलग मुश्किल
Instrumental बनाना एक काम है; शब्दों को सुर-ताल में, साफ़ उच्चारण के साथ गवाना दूसरा। कई text-to-music models यह करते ही नहीं। MusicGen का model card कहता है कि वह realistic vocals नहीं बना सकता, और Stable Audio Open समझ में आने वाली बोली नहीं बना सकता।
गाने वाले models को बोल अलग input के रूप में चाहिए। 2025 के open model YuE के लेखकों ने तीन दिक्कतें दर्ज कीं:
- साज़ आवाज़ को दबा देते हैं। उनके शब्दों में: "Accompaniment can overshadow the vocal track, degrading lyric intelligibility." उनका हल था हर पल के लिए दो tokens, एक आवाज़ का और एक संगत का।
- शुरुआत के बोल छूट जाते हैं। शुरुआत में दिया text करीब 3,000 tokens के बाद असर खोने लगा और 6,000 के बाद पूरी तरह नाकाम रहा। इसलिए उन्होंने हर section का नाम और बोल उसी section के audio के साथ जोड़े।
- भाषाओं का असंतुलन। Training के पहले चरण में सिर्फ़ English और Chinese data लिया गया, क्योंकि dataset में यही हावी थीं। जिन भाषाओं का data कम है, उनमें उच्चारण कमज़ोर रहने की संभावना ज़्यादा है।
genre, tempo, साज़ और mood के शब्द ही क्यों काम करते हैं
क्योंकि training में संगीत के साथ यही शब्द लिखे थे। MusicGen की टीम ने key, tempo और साज़ों जैसे tags को text description से जोड़कर train किया, और Stable Audio Open के training prompts भी genres और tags जैसे metadata से बने। "slow, sad, sarangi" लिखने पर model के पास उन शब्दों के साथ सुनी आवाज़ों की छाप होती है; "मेरे बचपन की गर्मियों जैसा" उसके लिए लगभग खाली शब्द हैं। Mood वाले शब्दों पर हमारी English गाइड AI models mood वाले prompts कैसे समझते हैं देखिए।
काम का ढाँचा: पहले genre, फिर BPM, फिर तीन से पाँच साज़, फिर mood और आवाज़ का प्रकार। जैसे: "romantic Bollywood ballad, 90 BPM, tabla, sitar, soft strings, rainy-night mood, male vocal"।
कहाँ गड़बड़ होती है, और उसे कैसे संभालें
1. लंबे गाने का ढाँचा टूटना. मुखड़ा उसी रूप में नहीं लौटता, या अंतरा भटक जाता है, क्योंकि window सीमित है और लंबे क्रम में शुरुआत का संदर्भ छूटने लगता है। MusicGen का card यह भी मानता है कि model कभी-कभी गाने का अंत बनाकर चुप्पी में चला जाता है। हल: [Verse] और [Chorus] जैसे section tags लगाइए, और ज़रूरत हो तो हिस्सों में बनाकर जोड़िए। तकनीकी वजहें हमारी गाइड लंबे AI गानों की तकनीकी अड़चनें में हैं।
2. उच्चारण बिगड़ना. मात्राएँ खिंच जाती हैं, "ड़" या अनुनासिक आवाज़ें गड़बड़ होती हैं, या दो शब्द जुड़ जाते हैं। हल: छोटी lines, पहले एक छोटा verse, और बार-बार बिगड़ने वाले शब्द की जगह आसान पर्यायवाची। ज़्यादा तरीके हमारी गाइड एआई सिंगिंग जनरेटर के इस्तेमाल के टिप्स में हैं।
3. Prompt से भटकना. आपने पाँच चीज़ें माँगीं, model ने तीन सुनीं। Stable Audio Open के paper में "then", "while", "after" जैसे जोड़ने वाले शब्दों वाले prompts में अक्सर कोई एक आवाज़ छूट जाती थी। हल: एक prompt में एक दृश्य, जो चाहिए वही लिखिए, और कुछ takes में से सबसे अच्छा चुनिए।
4. भारतीय रंग का फीका पड़ना. साज़ों के नाम साफ़ लिखिए, और जहाँ धुन का भारतीय मोड़ ज़रूरी है, वहाँ धुन खुद गुनगुनाकर दीजिए। MusicLM के paper ने दिखाया था कि गुनगुनाई या सीटी में बजाई धुन को text में बताई शैली में ढाला जा सकता है।
Soundverse कहाँ फिट होता है
Soundverse एक AI music platform है जो आपको idea से audience तक ले जाता है। उसके अंदर के models पर हम यहाँ कुछ नहीं कह रहे। AI Music Generator instrumental के लिए prompt के साथ tags लेता है: दो genres तक, एक theme, तीन vibes तक, पाँच instruments तक और एक tempo, जिनमें Bollywood genre और Tabla, Sitar भी हैं। AI Song Generator का Custom mode आपके Hindi बोल भी ठीक वैसे ही गाता है जैसे लिखे हैं, [Verse] और [Chorus] जैसे section tags के साथ। Pro और Max वाले Soundverse v9 का पेज भी कहता है कि भाषाओं की सूची प्रकाशित नहीं है, इसलिए पहले एक छोटा verse आज़माएँ। Melody to Song Generator 5 से 60 सेकंड की आपकी गुनगुनाई धुन पर गाना बनाता है, और AI Music Teacher (Teaching Agent) Hindi समेत सात भाषाओं में पढ़ाता है। लाइसेंसिंग प्लान के हिसाब से तय होती है: Free प्लान पर्सनल इस्तेमाल के लिए है, और Creator प्लान के साथ रॉयल्टी-फ़्री लाइसेंस मिलता है।
इस walkthrough में 0:17 से AI Music Generator वाला हिस्सा है, जिसमें एक prompt से instrumental बनता दिखता है।
FAQ
क्या AI म्यूजिक जनरेटर संगीत को "समझता" है? नियमों की तरह नहीं। वह सुने हुए संगीत से सुर, ताल और आवाज़ों के पैटर्न सीखता है, इसलिए नतीजा अक्सर theory के मुताबिक़ लगता है, पर अंदर कोई नियम जाँचने नहीं बैठा। BPM या साज़ का नाम तभी असर करता है जब वैसे शब्द training में आए हों।
एक ही prompt से हर बार अलग गाना क्यों बनता है? हर run संभावनाओं में से नया रास्ता चुनता है: token models अगला token चुनते समय, और diffusion models हर बार अलग noise से शुरू करके। इसलिए कई takes बनाकर चुनना समझदारी है।
क्या prompt Hindi में लिख सकते हैं? लिख सकते हैं, पर नतीजा tool पर निर्भर है। जिन research models के दस्तावेज़ हमने पढ़े, वे मुख्य रूप से English विवरणों पर train हुए थे, इसलिए एक ही idea दोनों भाषाओं में आज़माकर कानों से तय कीजिए।
क्या AI पुराने गानों के टुकड़े जोड़कर गाना बनाता है? आम तौर पर नहीं; वह सीखे हुए पैटर्न से नया audio बनाता है। फिर भी नकल का ख़तरा शून्य नहीं माना जाता, इसीलिए MusicGen और YuE के लेखकों ने अपने papers में अलग से जाँचा कि model training data दोहराता है या नहीं। रिलीज़ से पहले की जाँच पर हमारी गाइड क्या एआई से बनी धुनें पूरी तरह से ओरिजिनल होती हैं पढ़िए।
Soundverse पर free साइन अप करें और ऊपर वाले ढाँचे में अपना पहला prompt आज़माइए। ऐसी और गाइड Soundverse blog पर पढ़ें।
